Da die KI-Arbeitslasten sprunghaft ansteigen, treiben Rechenzentren nun ein explosives Wachstum des Strombedarfs voran, wodurch die Netzstabilität von Rechenzentren zu einem betrieblichen Muss statt einer Nebensache wird. Im Jahr 2024 verbrauchten Rechenzentren etwa 415 TWh (≈1,5 % des weltweiten Stroms), wobei Prognosen zeigen, dass sich die US-Nachfrage durch das KI-Wachstum nahezu verdoppelt (von 176 TWh im Jahr 2023 auf 325–580 TWh bis 2028). Dieses beispiellose Ausmaß macht eine stabile Stromversorgung zu einem betrieblichen Muss. Hohe Rack-Dichten (mehrere zehn kW pro Rack) und synchrone GPU-Cluster erzeugen extrem dynamische, stoßartige Lasten, weshalb die Netzstabilität von KI-Rechenzentren zu einer eigenständigen technischen Herausforderung geworden ist. Während Trainingsläufen kann die Leistung eines Rechenzentrums schnell zwischen Rechen- und Kommunikationsphasen schwanken und große Spannungs- und Frequenztransienten verursachen. Im Grunde verlagert KI das Problem von Kapazität (wie viel Leistung) zur Steuerung (wie schnell sich die Leistung ändert). Herkömmliche USV- und Generatorkonzepte – ausgelegt für vorhersehbare Lasten – geraten an ihre Grenzen. Branchenexperten warnen, dass „Leistungsstabilität und Effizienz keine technischen Nebenthemen mehr sind; sie sind Betriebsrisiken" in KI-Anlagen der nächsten Generation.
Netzstabilität von Rechenzentren ist die Fähigkeit einer Anlage, ihre IT-Last kontinuierlich mit sauberem, spezifikationskonformem Strom zu versorgen, ohne dabei durch externe Netzstörungen beeinträchtigt zu werden oder das Netz, aus dem sie sich speist, selbst zu stören. Sie umfasst alles von Millisekunden-Spannungstransienten an einer internen Stromschiene bis hin zu Lastschwankungen im Multi-Megawatt-Bereich, die sich nach außen bis in ein regionales Übertragungsnetz fortpflanzen.
Wie viel auf dem Spiel steht, wird leicht unterschätzt – bis etwas ausfällt. Strombezogene Probleme sind nach wie vor die mit Abstand größte Ursache für schwerwiegende Rechenzentrumsausfälle und machen rund 45 Prozent der folgenreichen Vorfälle aus, von denen die Mehrheit mit der Strominfrastruktur wie unterbrechungsfreien Stromversorgungen zusammenhängt. Die finanziellen Folgen sind gravierend: Ausfallzeiten in Großunternehmen können in der Größenordnung von Tausenden von Dollar pro Minute liegen, und rund jeder fünfte finanziell folgenreiche Ausfall kostet inzwischen mehr als drei Millionen Dollar. Wenn der gesamte Zweck einer Anlage darin besteht, ununterbrochen zu laufen, ist Instabilität keine Lästigkeit – sie ist ein existenzielles Risiko.
Was sich geändert hat, ist das Ausmaß und der Charakter der Last. Der weltweite Stromverbrauch von Rechenzentren lag 2024 bei etwa 415 Terawattstunden, rund 1,5 Prozent des globalen Stroms, und wird sich bis 2030 auf etwa 945 Terawattstunden mehr als verdoppeln, wobei die KI-optimierte Kapazität am schnellsten von allen wächst. Dieses Wachstum allein würde jedes Netz belasten. Doch nicht der durchschnittliche Verbrauch bedroht die Stabilität – sondern die Art und Weise, wie KI-Arbeitslasten Strom verbrauchen.
Das jahrhundertealte Design des Stromnetzes beruht auf einer stillen Annahme, die als Lastdiversität bezeichnet wird. In einer herkömmlichen Anlage fahren einzelne Server zu unterschiedlichen Zeitpunkten hoch und herunter, sodass sich ihre Schwankungen gegenseitig aufheben und die Gesamtabnahme gleichmäßig bleibt. Auf diesem Fundament wurden die meisten Strategien zur Netzstabilität von Rechenzentren aufgebaut – und KI-Trainingscluster zerstören diese Annahme.
Bei einem großen Trainingslauf arbeiten Zehntausende – manchmal mehr als Hunderttausend – GPUs im Gleichschritt an derselben iterativen Aufgabe. Sie steigen während der Rechenphase bis nahe an ihre thermische Auslegungsleistung an und fallen dann während der Kommunikationsphase nahezu auf Leerlauf, wenn die Ergebnisse clusterweit in Operationen wie All-Reduce oder Checkpointing synchronisiert werden. Da jeder Prozessor im selben Moment umschaltet, mitteln sich die Schwankungen nicht heraus. Sie summieren sich. Das Ergebnis ist eine koordinierte Leistungsschwingung, die innerhalb von Sekunden – und manchmal innerhalb eines Sekundenbruchteils – zehn bis hunderte Megawatt verschieben kann
Der heimtückischste Aspekt dieses Verhaltens ist nicht seine Größe, sondern sein Rhythmus. Als Forscher mehrerer führender KI- und Chip-Unternehmen in einer Studie aus dem Jahr 2025 Leistungsverläufe aus dem Produktivbetrieb großer GPU-Cluster analysierten, stellten sie fest, dass sich die Schwingungsenergie zwischen etwa 0,2 und 3 Hertz konzentrierte. Dieses Band liegt gefährlich nahe an den natürlichen Resonanzmoden von Turbinengeneratorwellen und langen Übertragungsleitungen, die von etwa 0,16 Hertz bis weit über 60 Hertz reichen. Wenn eine Anregungsfrequenz nahe einer mechanischen oder elektrischen Resonanz liegt, sammelt sich Energie an, statt sich abzubauen, und zu den Folgen gehören subsynchrone Resonanz, Spannungsflackern und mechanische Ermüdung in Generatorwellen Hunderte von Kilometern entfernt. Ein GuD-Kraftwerk in Florida erlebte 2019 genau diese Art von Schwingung, ausgelöst durch eine Quelle von rund 200 Megawatt; die synchronisierten KI-Lasten, die jetzt ans Netz gehen, können weitaus größer sein.
Über die Resonanz hinaus gibt es die schiere Geschwindigkeit der Veränderung. Wenn eine Trainingsaufgabe startet, pausiert oder endet, kann die Last schneller ansteigen oder zusammenbrechen, als die Generatoren vor Ort folgen können. Netzzuverlässigkeitsbehörden haben extreme KI-Trainingsschwankungen als Risiko mit hoher Wahrscheinlichkeit und großer Auswirkung eingestuft und darauf hingewiesen, dass die Nachfrage binnen Momenten um Hunderte von Megawatt einbrechen und ebenso schnell wieder ansteigen kann. GPUs verschärfen die Herausforderung durch kurze Überschwinger über ihre Nennleistung hinaus – Spitzen der elektrischen Auslegungsleistung von rund fünfzig Millisekunden Dauer –, die, wenn sie am Netzanschlusspunkt der Anlage sichtbar werden, jede Konformitätsmarge verengen. Die technische Realität ist, dass Software, Firmware und Tricks auf GPU-Ebene diese Transienten abmildern können, aber keines davon sie vollständig beseitigt. Eine vollständige Antwort erfordert Hardware, die Energie in der Geschwindigkeit aufnehmen und abgeben kann, die die GPUs verlangen.
Mit dem wachsenden Strombedarf von KI-Fabriken muss sich das Verhältnis zwischen Rechenzentrumsbetreibern und Versorgungsunternehmen von einer passiven Verbindung zu einem Modell der Netzabhängigkeit wandeln, das die Netzstabilität von Rechenzentren in den Mittelpunkt der Vereinbarung stellt. In diesem kooperativen Rahmen nutzen Rechenzentren ihre Vor-Ort-Energiespeicher und Anlagen zur Netzkonditionierung, um das lokale Netz in Zeiten von Spitzenlast oder bei Systemnotfällen zu unterstützen.
| Parameter / Kennzahl | Herkömmliche Rack-Stromarchitektur | Moderne PCS-fähige Rack-Architektur |
|---|---|---|
| Dynamische Reaktionsgeschwindigkeit | > 10 (softwarebasierte Anstiegssteuerung) | < 10 µs (hardwarebasierte autonome Entladung) |
| Netzanschlussleistungsbedarf | Ausgelegt auf GPU-Spitzenlasten (150 % des Nennwerts) | Gekappte Spitze; Anschlussbedarf um bis zu 44 % reduziert |
| Künstliche / Blindlasten | Erforderlich zur Glättung des Netzlastprofils (verschwendet Energie) | Vollständig eliminiert; direkte physische Pufferung |
| Energieeffizienz des Systems | Hohe thermische Verluste und Kühlaufwand | Bis zu 45 % höhere Gesamt-Stromeffizienz des Racks |
| Wärmeabfuhr (Rack-Ebene) | Erhöht durch kontinuierliches Verheizen von Blindlasten | Um bis zu 45 % reduziert, senkt die Kühl-OPEX |
| CAPEX-Auswirkungen (400-MW-Anlage) | Hohe Netzanschlussgebühren und Transformatornennleistungen | Bis zu 40 Mio. $ Einsparung bei Netzanschluss-/Infrastrukturkosten |
Bei einem lokal begrenzten Fehler auf einer Übertragungsleitung können die Spannungspegel steil abfallen, bevor Schutzrelais den Fehler isolieren. In der Vergangenheit reagierten Rechenzentren auf diese Spannungseinbrüche, indem sie sich sofort vom Netz trennten und ihre gesamte Last auf Notstrom-Dieselgeneratoren umschalteten.
Da die Lasten von Rechenzentren jedoch zu einem erheblichen Anteil an der regionalen Nachfrage anwachsen, kann die gleichzeitige Abschaltung mehrerer hundert Megawatt Last einen katastrophalen Netzausfall auslösen, wodurch die Netzstabilität von Rechenzentren zu einem netzweiten Anliegen statt einer Angelegenheit einer einzelnen Anlage wird. Folglich setzen Übertragungsnetzbetreiber (ÜNB) weltweit strenge Fault-Ride-Through-(FRT-)Vorschriften durch. Diese Regelungen schreiben vor, dass Rechenzentren während transienter Fehler mit dem Versorgungsnetz verbunden bleiben und die Netzwiederherstellung aktiv unterstützen, anstatt sich zu trennen.
Die Umsetzung FRT-konformer Architekturen erfordert fortschrittliche USV-Regelalgorithmen und robuste Wechselrichter-Hardware, die für transiente Überströme ausgelegt ist. Durch den Einsatz von digitalen Zwillingssimulationen in Echtzeit können Ingenieure validieren, dass diese Regelungssysteme wirksam mit den Schutzkonzepten des Versorgungsnetzes zusammenwirken, und so einen nahtlosen Betrieb bei dynamischen Fehlern sicherstellen.
Mit der Verringerung der physischen Netzträgheit durch die Integration erneuerbarer Energien ist die Netzfrequenz anfälliger für rasche Einbrüche bei Generatorausfällen. Die Fast Frequency Reserve (FFR) ist ein aktiver Netzstützmechanismus, der hilft, diese Frequenzeinbrüche abzumildern.
Bei diesem Modell konfigurieren Rechenzentren ihre USV und Batteriespeichersystemen (BESS) , um Netzfrequenzabweichungen zu erkennen. Als Reaktion darauf kann das Rechenzentrum seinen Netzstrombezug vorübergehend reduzieren – oder gespeicherte Energie zurück ins Netz einspeisen – für bis zu 30 Sekunden. Diese schnelle Reaktion verschafft dem Versorgungsunternehmen das entscheidende Zeitfenster, das es braucht, um sekundäre Erzeugungsquellen (etwa Wasserkraft- oder Gasturbinenreserven) hochzufahren, ohne die kritischen IT-Arbeitslasten des Rechenzentrums zu unterbrechen.
Diese Modelle zur Netzstabilisierung eröffnen Rechenzentrumsbetreibern eine klare kommerzielle Chance und verwandeln die Netzstabilität von KI-Rechenzentren von einem reinen Kostenfaktor in eine Wertquelle. Durch die Nutzung vorhandener, oft ungenutzter Energiespeicheranlagen können Betreiber an Demand-Response-Programmen der Versorger teilnehmen und zusätzliche Einnahmequellen erschließen, um die Betriebskosten auszugleichen.
Im Kern vieler Stabilitätslösungen steht die Energiespeicherung – sie puffert Leistung während der Spitzen und gibt sie bei Bedarf ab. Dies ist einer der direktesten Hebel für die Netzstabilität von Rechenzentren, und Rechenzentrumsbetreiber behandeln Batterien und Superkondensatoren zunehmend nicht nur als Notstromreserve, sondern als aktive Netzressourcen. Branchenforschung prognostiziert, dass der weltweite Batteriebedarf von Rechenzentren stark ansteigen wird (von heute ~20 GWh auf ~70 GWh bis 2030), da immer mehr Standorte Speicher zum Lastmanagement einsetzen. Speicher können mehrere Rollen erfüllen: die Betriebszeit bei Netzausfällen verlängern, erneuerbare Energien speichern, Dieselgeneratoren durch eine sauberere Notstromversorgung ersetzen – und, entscheidend, interne Lastschwankungen glätten.
Während Tricks auf Softwareebene (wie das zeitversetzte Starten von Aufgaben) teilweise Entlastung bieten, gehen sie oft mit Effizienzverlusten einher. Hardware-Speicher bietet eine direktere Lösung. Lithium-Ionen- oder fortschrittliche Blei-Säure-USV-Batterien können eine Leistungsspitze schnell aufnehmen oder ein Tal ausgleichen. EnerSys weist beispielsweise darauf hin, dass ihre Dünnplatten-Reinblei-Batterien (TPPL) „außergewöhnliche Schnelllade- und Zyklenfähigkeiten besitzen, die für die Netzstabilisierung erforderlich sind." Diese Batterien sind auf hohe Leistungsdichte ausgelegt und können sich schnell wieder aufladen, um Spitzen zu kappen. Durch die Integration solcher Hochleistungs-USV-Batterien kann ein Rechenzentrum eine aggressivere Lastfolge unterstützen und sogar an Netzdiensten der Versorger teilnehmen. Entscheidend ist, dass Betreiber sicherstellen müssen, dass die Speicherbeteiligung die grundlegende Betriebszeit nicht gefährdet: Sie müssen die Reserve so dimensionieren und verwalten, dass die primären geschäftskritischen Lasten geschützt bleiben.
Um die Lücke zwischen der volatilen GPU-Nachfrage und den starren Netzbeschränkungen zu überbrücken, setzen Betreiber lokale, ins Rack integrierte Energiespeichersysteme ein. Während herkömmliche Batteriespeichersystemen (BESS) für die Langzeit-Notstromversorgung gut geeignet sind, reichen ihre Reaktionszeiten und Zykluslebensdauern für Lastspitzenkappung im Millisekundenbereich nicht aus. Diese Lücke hat zur Einführung des Leistungskondensator-Regals (PCS) als kritische Komponente in modernen Architekturen für die Netzstabilität von KI-Rechenzentren geführt.
Ein Leistungskondensator-Regal arbeitet direkt auf Rack-Ebene (oft nach den Standards Open Rack V3 bzw. ORV3 ausgelegt) und nutzt hochkapazitive elektrochemische Doppelschichtkondensatoren (EDLCs), auch Superkondensatoren genannt, um schnelle Lade- und Entladefähigkeiten bereitzustellen.
Die Hauptfunktion eines PCS besteht darin, „Lastspitzenkappung und Talfüllung" auszuführen. Wenn die GPUs in Spitzenrechenzustände übergehen und momentane Ströme fordern, die die sicheren Betriebsgrenzen der vorgelagerten Stromverteilungseinheiten (PDUs) überschreiten, gibt das PCS seine gespeicherte Energie in weniger als 10 µs. Umgekehrt lädt sich das PCS wieder auf, wenn die GPUs in Leerlauf- oder Kommunikationszustände wechseln, und glättet so das vom Netz gesehene Leistungsbedarfsprofil.
Diese Einheiten werden typischerweise in standardisierten Formfaktoren entwickelt, die auf eine nahtlose Integration ausgelegt sind. Die elektrische Leistung dieser Module ist auf eine schnelle Energieabgabe optimiert, wie in den Spezifikationen moderner Hochdichte-Kondensatorplattformen zusammengefasst:
| Parameter / Spezifikation | 48-VDC-Schnittstellenmodul | 400-VDC-Schnittstellenmodul |
|---|---|---|
| Formfaktor / Kompatibilität | ORV3-kompatibel, 1OU hoch | ORV3-kompatibel, 3OU / 4OU hoch |
| Spitzenleistung | 60 kW | 160 kW |
| Spitzenstromfähigkeit | 1250 A | 400 A |
| Dauerstrom-Nennwert | 830 A | 300 A |
| Kühlmethoden-Optionen | Luft- und flüssigkeitsgekühlte Optionen | Luft- und flüssigkeitsgekühlte Optionen |
| Kern-Speichertechnologie | Gebogene Graphen-Superkondensatoren | Gebogene Graphen-Superkondensatoren |
Durch die physische Entkopplung des momentanen Silizium-Bedarfs von der vorgelagerten Stromverteilung macht ein Leistungskondensator-Regal die softwarebasierten „Blindlasten" überflüssig, die Betreiber in der Vergangenheit zur Aufrechterhaltung eines flachen Lastprofils einsetzten. Diese physische Pufferung verringert die gesamte Wärmeentwicklung innerhalb des Servergehäuses, senkt den Kühlaufwand und verbessert die Gesamt-Energieeffizienz (Power Usage Effectiveness, PUE) der Anlage erheblich.
Eine stabile Stromversorgung beginnt ebenfalls auf Hardwareebene – vom Kraftwerk bis hinunter zum Rack. Moderne KI-Server und -Racks verwenden oft höhere Busspannungen und dichtere Leiterplatten-Layouts als früher. Ein aktueller Technologieleitfaden betont, dass sich die PDN-Architektur weiterentwickeln muss, um Verluste zu verringern und die Spannung bei hoher Last aufrechtzuerhalten. Neuere Serverdesigns können beispielsweise verteilte DC-Busse (z. B. ±400 V oder höher) und verstärkte Entkopplungskondensatoren verwenden. Die Bauteilauswahl ist entscheidend: hochwertige Vielschicht-Keramikkondensatoren (MLCCs), Folienkondensatoren, Elektrolytkondensatoren mit niedrigem ESR und Siliziumkondensatoren tragen alle dazu bei, die Spannungsschienen zu stabilisieren. Wie Murata anmerkt, sollten PDNs von Rechenzentren fortschrittliche passive Bauteile und eine optimierte Platzierung nutzen, um Transienten zu absorbieren und Spannungsabfälle zu minimieren. In einer verrauschten Hochfrequenzwelt zählt jedes Nanofarad an Abblockung.
Das Design auf Platinenebene beeinflusst ebenfalls die Stabilität. Die Minimierung der Schleifeninduktivität und die Vermeidung von Resonanzen verringern Spannungsüberschwinger. Leistungsstufen für KI-Beschleuniger sind im Wesentlichen MHz-Klasse- DC-DC-Wandler – sie können Rauschen und Oberschwingungen in die Leitung einspeisen. PDN-Entwickler simulieren heute routinemäßig vollständige elektrothermische Modelle von Servern und Racks unter dynamischer Last und stellen sicher, dass kein Teil des Versorgungsnetzes bei schnellen Ereignissen sättigt oder schwingt. Kurz gesagt: Ein optimiertes PDN-Design ist eine Verteidigung an vorderster Front – es schafft eine robuste Basis, sodass der Spannungseinbruch beherrschbar bleibt, wenn eine KI-Lastspitze auftritt. Dies deckt sich mit der Branchenempfehlung, dass „sich weiterentwickelnde Architekturen zur Leistungsplatzierung" – von massiven Kupferflächen bis zu verteilten Abblocknetzwerken – erforderlich sind, um die Stromversorgung von KI-Servern zu stabilisieren und Verluste zu verringern.
Ein Leistungskondensator-Regal zu bauen, das im Feld funktioniert, ist weitaus schwieriger, als Kondensatoren in Reihe und parallel zu verschalten. Die Disziplin des PCS-Moduldesigns dreht sich um einen dominanten Parameter – den äquivalenten Serienwiderstand, kurz ESR – einen kleinen Innenwiderstand, der vier miteinander gekoppelte Ergebnisse bestimmt:
Diese Effekte verstärken sich auf Modulebene auf eine Weise, die unerfahrene Entwickler unvorbereitet trifft:
Den ESR korrekt zu messen ist eine eigene Herausforderung, und ihn falsch zu bestimmen untergräbt das gesamte Design:
Ein Leistungskondensator-Regal, ein Superkondensatormodul, eine netzfreundliche USV, eine 800-Volt-DC-Stromarchitektur: Jede davon führt schnelle Regelschleifen und neue Fehlerarten ein, die sich auf einem Datenblatt nicht offenbaren und ebenso wenig bei einem harmlosen Prüfstandstest. Diese Probleme bleiben bis zum denkbar schlechtesten Moment verborgen, sofern sie nicht vorher gezielt provoziert werden:
Dies ist der Teil der Stabilitätsgeschichte, den der Rest der Branche gern überspringt, und genau hier liegt die eigentliche Absicherung. Leistungsstabilität muss nicht nur konstruiert, sondern auch unter realistischen Netz- und Lastbedingungen verifiziert werden, bevor eine Anlage ans Live-Netz geht:
Genau diese Rolle spielt Impedyme. Statt Kondensator-Regale oder USV-Systeme herzustellen, baut Impedyme die Test- und Emulationsplattformen, die beweisen, dass diese Systeme funktionieren – was das Unternehmen zu einer neutralen Instanz macht, die das Powershelf, PCS-Modul, HVDC-Wandleroder komplette Rack jedes beliebigen Anbieters validieren kann:
In einer Zeit, in der ein einziges Instabilitätsereignis tausend Megawatt abwerfen und eine behördliche Warnung auslösen kann, ist die Validierung vor der Inbetriebnahme keine optionale Sorgfaltspflicht mehr. Sie ist der Unterschied zwischen einer Anlage, die das Netz stärkt, und einer, die es gefährdet.
Die Validierung des Zusammenspiels zwischen einem neu entworfenen PCS-Modul, den Netzteilen der Server (PSUs) und dem dynamischen Versorgungsnetz erfordert eine rigorose Testmethodik. In der Vergangenheit verließen sich Entwicklungsingenieure auf numerische Softwaresimulationen, um das Systemverhalten zu modellieren. Reine Softwaresimulationen können jedoch firmwarespezifische Timing-Anomalien, nichtlineares Hochleistungs-Hardwareverhalten oder Wechselwirkungen der Regelschleifen zwischen mehreren parallelen Wechselrichtern nicht erfassen. Umgekehrt sind Live-Tests an physischen Netzanschlüssen oder an Betriebslasten im Multi-Megawatt-Bereich gefährlich, wirtschaftlich unvertretbar und können seltene Grenzfall-Fehlerbedingungen nicht sicher nachbilden.
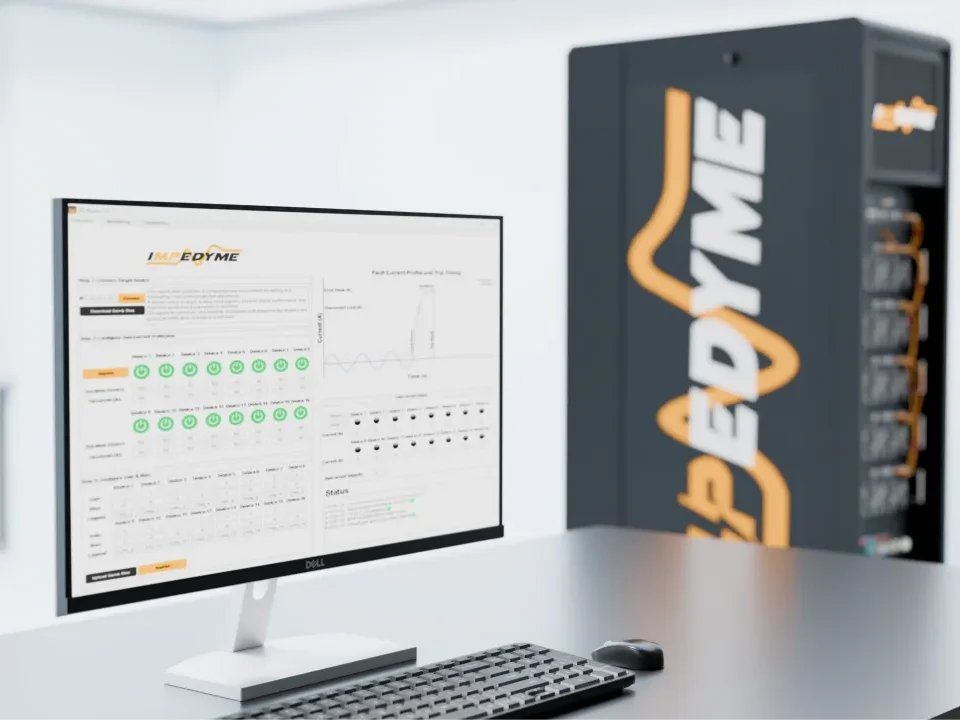
Dieser Herausforderung begegnet Impedyme , indem es eine hochpräzise Validierungsplattform bereitstellt, die kombinierte Hardware-in-the-Loop-(HIL-) und Power-Hardware-in-the-Loop-(PHIL-) Technologie nutzt. Diese Plattform ermöglicht es Entwicklern, physische Steuerungshardware und reale Leistungsanlagen (etwa ein physisches PCS-Modul oder eine USV) mit einer simulierten Echtzeit-Umgebung zu koppeln.
Über diese geschlossene Testarchitektur tauscht ein physisches Prüfobjekt (Device Under Test, DUT) reale Leistung mit einem simulierten digitalen Zwilling des Versorgungsnetzes oder des Stromversorgungssystems eines Rechenzentrums aus. Diese Validierungsmethodik ist entscheidend, um zu analysieren, wie physische Leistungselektronik auf tiefe Spannungseinbrüche, Netzkurzschlüsse, transiente Netzoberschwingungen und plötzliche Laststufenänderungen im Multi-Megawatt-Bereich reagiert.
Die zentrale technische Herausforderung in der PHIL-Umgebung besteht darin, die Schnittstellenstabilität und die Synchronisation der geschlossenen Regelschleife zwischen der physischen Hardware und dem Echtzeit-Simulationsmodell aufrechtzuerhalten. Jede Verzögerung oder Latenz in der Rückkopplungsschleife zwischen den physischen Sensoren, dem Echtzeitrechner und den Leistungsverstärkern kann künstliche Phasenverschiebungen einführen und die Simulation destabilisieren.
Um die numerische Stabilität zu wahren und hochfrequente Transienten präzise zu erfassen, muss der Zeitschritt der Echtzeitsimulation proportional zur Frequenz der analysierten Dynamik skalieren. Mathematisch muss der Zeitschritt zur Wahrung der numerischen Stabilität mindestens eine Größenordnung kleiner sein als die schnellste relevante elektrische Periode:
| Anwendung / dynamisches Phänomen | Zielfrequenz / -periode | Erforderlicher Zeitschritt | Fähigkeit der Impedyme-Plattform |
|---|---|---|---|
| Netzfrequenzdynamik | 50 Hz / 60 Hz (16.6 ms) | ≈ 1.6 ms | Vollständig unterstützt |
| Netzoberschwingungen 50. Ordnung | 3 kHz (333us) | ≤ 33 μs | Vollständig unterstützt |
| Bandbreite der Wechselrichter-Regelschleife | 2 kHz (500us) | ≤ 50 μs | Vollständig unterstützt |
| Hochgeschwindigkeits-PWM-Ripple und -Transienten | 10 kHz-50 kHz (20us) | ≤ 2 µs bis 5 µs | Unterstützt über FPGA-Ausführung |
| Nanosekunden-FPGA-Echtzeitkern | > 1 MHz (1us) | Nanosekundenbereich | Nativer FPGA-Hardware-Zeitschritt |
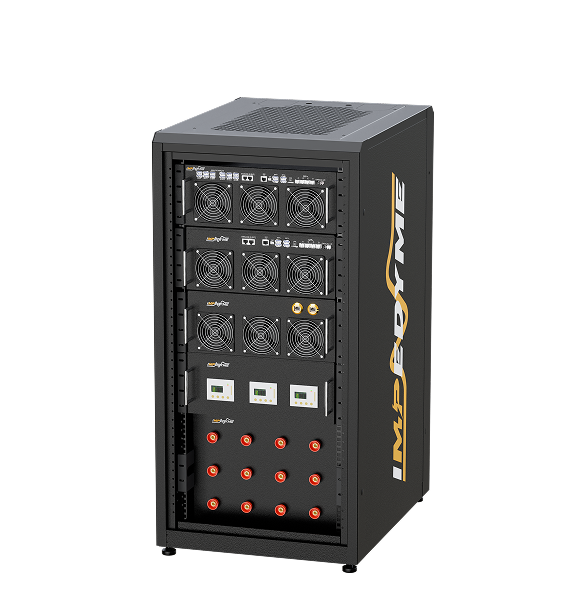
Das kombinierte HIL- und Power-HIL-System (CHP) von Impedyme adressiert diese ultraschnellen Timing-Anforderungen durch den Einsatz dedizierter FPGA-basierter Echtzeitprozessoren. Dieses Design ermöglicht Ausführungsschritte im Nanosekundenbereich und garantiert die Präzision im Mikrosekundenbereich, die zum Testen von Hochfrequenz-Wandlertopologien, Active-Front-End-(AFE-)Gleichrichtern und Hochgeschwindigkeits-Reglerlogik erforderlich ist.
Die Impedyme-CHP-Plattform unterstützt Hochleistungstests bis in den Megawattbereich und nutzt ein integriertes Flüssigkeits- und Luftkühlsystem, das keine externen Kältemaschinen benötigt. Dieses integrierte Wärmemanagement ermöglicht eine kontinuierliche Hochleistungsemulation, sodass Ingenieure Simulink-Modelle direkt über optische Verbindungen einspielen und eine Echtzeit-Impedanzspektroskopie ausführen können, um Frequenzgangkurven dynamisch zu erfassen.
Während Superkondensatoren die vom Servergehäuse geforderte transiente Reaktion im Millisekundenbereich liefern, ist ein Langzeit-Energiespeicher erforderlich, um netzinteraktive Betriebsarten und die Notstromversorgung der Anlage zu unterstützen. Die Wahl der geeigneten Batteriechemie ist eine grundlegende Designentscheidung, die den Platzbedarf, die Zyklenlebensdauer und das Wärmemanagementprofil der Anlage bestimmt, und sie steht im Zentrum der langfristigen Netzstabilität von Rechenzentren.
In der Vergangenheit dominierten herkömmliche Blei-Säure-Batterien aufgrund ihrer Wirtschaftlichkeit und Zuverlässigkeit den Standby-Markt für Rechenzentren. Die hohen zyklischen Anforderungen der aktiven Netzstabilisierung haben jedoch die Einführung fortschrittlicher Alternativtechnologien vorangetrieben.
Innovationen bei der Dünnplatten-Reinblei-Technologie (TPPL) nutzen dünnere Platten, um die aktive Oberfläche zu maximieren, was die Leistungsdichte und die Zyklenfähigkeiten erheblich steigert. Dieses Reinblei-Gitterdesign verhindert die innere Degradation und ermöglicht es den Batterien, bei erhöhten Temperaturen von bis zu 30 °C zu arbeiten. Diese thermische Belastbarkeit verringert unmittelbar den Kühlenergieverbrauch der Anlage und senkt sowohl den PUE-Wert als auch den betrieblichen CO2-Fußabdruck.
Netzstabilität von Rechenzentren im Zeitalter hochdichter KI zu erreichen erfordert einen einheitlichen Engineering-Ansatz, der vom Chipdesign bis hinunter zu Hochspannungs-Übertragungssystemen reicht. Um diese Herausforderungen zu bewältigen, sollten Betreiber und Entwickler mehrere strategische Maßnahmen priorisieren:
Integrieren Sie Leistungskondensator-Regale (PCS) auf Rack-Ebene mit ultraschnellen Reaktionszeiten im Mikrosekundenbereich, um hochfrequente GPU-Lastwechsel lokal zu puffern. Dieser Ansatz minimiert nachgelagerte Wärmelasten, reduziert den Bedarf an Spitzen-Netzanschlussleistung und steigert die Gesamteffizienz des Stromsystems.
Wenden Sie sich von Testprotokollen ab, die auf gleitenden Mittelwertalgorithmen beruhen, welche den ESR glätten und unterschätzen. Setzen Sie hochauflösende Transientenerfassung und hochfrequente Abtastung ein, um ESR-Abweichungen im Mikroohm-Bereich zu erkennen, bevor einzelne Zellen zu Modulen zusammengebaut werden, und verhindern Sie so thermische Ungleichgewichte und vorzeitiges Versagen des Regals.
Ersetzen Sie statische Softwaresimulationen durch Echtzeit-Hardware-in-the-Loop-(HIL-) und Power-Hardware-in-the-Loop-(PHIL-)Tests. Der Einsatz FPGA-basierter Plattformen mit Zeitschritten im Mikrosekundenbereich ermöglicht es Ingenieuren, das physische Zusammenspiel zwischen Wandlern, USV-Einheiten und dem Netz unter realistischen Bedingungen zu validieren und so das Risiko des Inbetriebnahmeprozesses zu verringern.
Setzen Sie programmierbare, bidirektionale Netzemulatoren ein, um die Geräteleistung unter komplexen Oberschwingungsbedingungen zu bewerten. Die Emulation unterschiedlicher Netzimpedanzen und Oberschwingungsprofile stellt die Konformität mit internationalen Normen wie IEEE 519-2014 sicher, während die regenerative Energierückgewinnung den Testenergieverbrauch senkt.
Investieren Sie in netzinteraktive Stromversorgungssysteme, die zu Fault Ride-Through (FRT) und Fast Frequency Reserve (FFR) fähig sind. Die Integration dieser aktiven Netzstabilisierungsfähigkeiten trägt dazu bei, lokale Verteilnetze zu stabilisieren, und erschließt gleichzeitig zusätzliche Einnahmequellen durch die Teilnahme an Demand-Response-Programmen.
Durch die Anwendung dieser fortschrittlichen Validierungsmethoden und Energiespeicherstrategien können Rechenzentrumsentwickler resiliente, hochdichte Ergebnisse für die Netzstabilität von KI-Rechenzentren erzielen, die das sich wandelnde Versorgungsnetz aktiv unterstützen und sich in dieses integrieren. Der Einsatz hochpräziser Echtzeit-Simulationsplattformen, wie sie von Impedyme bereitgestellt werden, ermöglicht es Betreibern, sich von passiven Stromverbrauchern zu aktiven, netzstützenden Partnern zu wandeln.
Was ist Netzstabilität von Rechenzentren?
Es ist die Fähigkeit einer Anlage, ihre IT-Last kontinuierlich und unterbrechungsfrei mit sauberem, spezifikationskonformem Strom zu versorgen, ohne dabei durch Netzstörungen beeinträchtigt zu werden oder das Netz selbst zu stören. Sie umfasst die interne Stromqualität, das Durchfahren von Fehlern und die externe Auswirkung der Anlage auf das weitere Netz.
Warum verursachen KI-Arbeitslasten Netzinstabilität?
Große KI-Trainingscluster betreiben Zehntausende von GPUs im Gleichschritt, sodass sie alle im selben Moment hochfahren und in den Leerlauf gehen, statt sich auszumitteln. Dies erzeugt synchronisierte Leistungsschwankungen von zehn bis hunderten Megawatt innerhalb von Sekunden, mit Schwingungsfrequenzen, die gefährlich mit den Eigenmoden von Turbinen und Übertragungsleitungen in Resonanz treten können.
Was ist ein Leistungskondensator-Regal (PCS)?
Ein Leistungskondensator-Regal ist eine rackmontierte Bank aus Hochleistungskondensatoren, die den Strombezug eines Racks durch Lastspitzenkappung und Talfüllung glättet – Aufladen in Phasen geringer Nachfrage und Entladen bei Nachfragespitzen –, sodass Netzteile, die USV und das Netz nie den vollen Transienten sehen, und das ohne die Energieverschwendung von Blindlasten.
Was ist PCS-Moduldesign und warum ist der ESR wichtig?
PCS-Moduldesign ist die technische Auslegung von Kondensatormodulen für eine stabile, hochleistungsfähige Lastspitzenkappung. Der äquivalente Serienwiderstand ist der maßgebliche Parameter, weil er gleichzeitig maximale Leistung, Überbrückungslaufzeit, Eigenerwärmung und Lebensdauer festlegt; kleine Abweichungen pro Zelle summieren sich nichtlinear über ein Modul, wodurch Zellenanpassung, Verbindungsimpedanz und eine präzise ESR-Messung entscheidend für die Leistung in der Praxis werden.
Wie testet oder validiert man die Netzstabilität von Rechenzentren?
Durch Power-Hardware-in-the-Loop- und Controller-Hardware-in-the-Loop-Tests, bei denen ein Echtzeitsimulator das Netz und die Arbeitslast emuliert, während die reale Hardware in einer geschlossenen Regelschleife reagiert. So können Ingenieure jedes Fehler-, Spannungseinbruch-, Lastrampen- und Fault-Ride-Through-Szenario proben, bevor sie sich mit dem Live-Netz verbinden.
Was ist Fault Ride-Through?
Fault Ride-Through ist die Fähigkeit einer Anlage, während einer Netzstörung verbunden und stützend zu bleiben, statt sich zu trennen. Regulierungsbehörden verlangen dies zunehmend von großen Lasten, damit Rechenzentren dazu beitragen, das Netz durch Fehler hindurch zu stabilisieren, anstatt das Ungleichgewicht durch massenhaftes Offline-Gehen zu verschärfen.